OpenAI crea BioBasicsBench: su mejor modelo resuelve 66,7% de 100 tareas de laboratorio con datos crudos
● Confianza media-alta · Medio
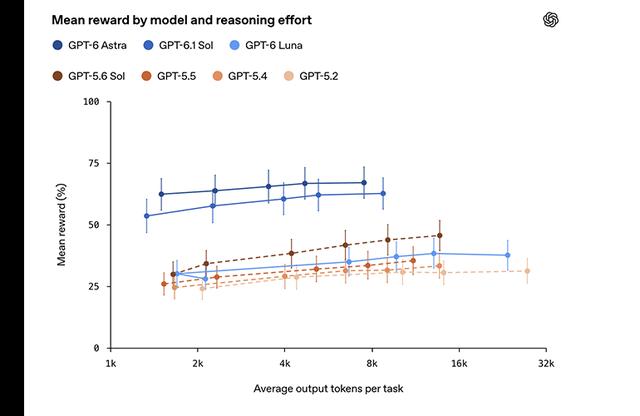
OpenAI presentó BioBasicsBench, una prueba hecha con la startup Ligo Biosciences que mide si los modelos interpretan datos crudos de 100 tareas rutinarias de laboratorio, informó R&D World el 6 de noviembre. GPT-6 Astra obtuvo el mejor puntaje, 66,7%, seguido de GPT-6.1 Sol con 62%. OpenAI advierte que un mejor puntaje no significa aún que los modelos puedan tomar decisiones confiables en el laboratorio.
Esta noticia apareció en la edición N° 070 de AI Radar.